
外観検査AIの異常検知とは|良品学習型AIは「どこまでOK」を学ばない
 kanrinin
良品学習型の外観検査AIを立ち上げると、まず過検出の多さに悩まされることが少なくありません。そこで「どこまでが良品なのかを教えたい」と限度ぎりぎりの品まで学習させると、今度は見逃しが生まれます。分かれ道になるのは、良品学習型AIが何を学んでいるかの理解です。本記事では、良品学習型AIを支える「異常検知」という技術が何を学んでいるのかと、運用の中で「いつもの姿」へ近づけていく実践的な考え方を、単純化した例で解説します。
欠陥ではなく、良品を学習する
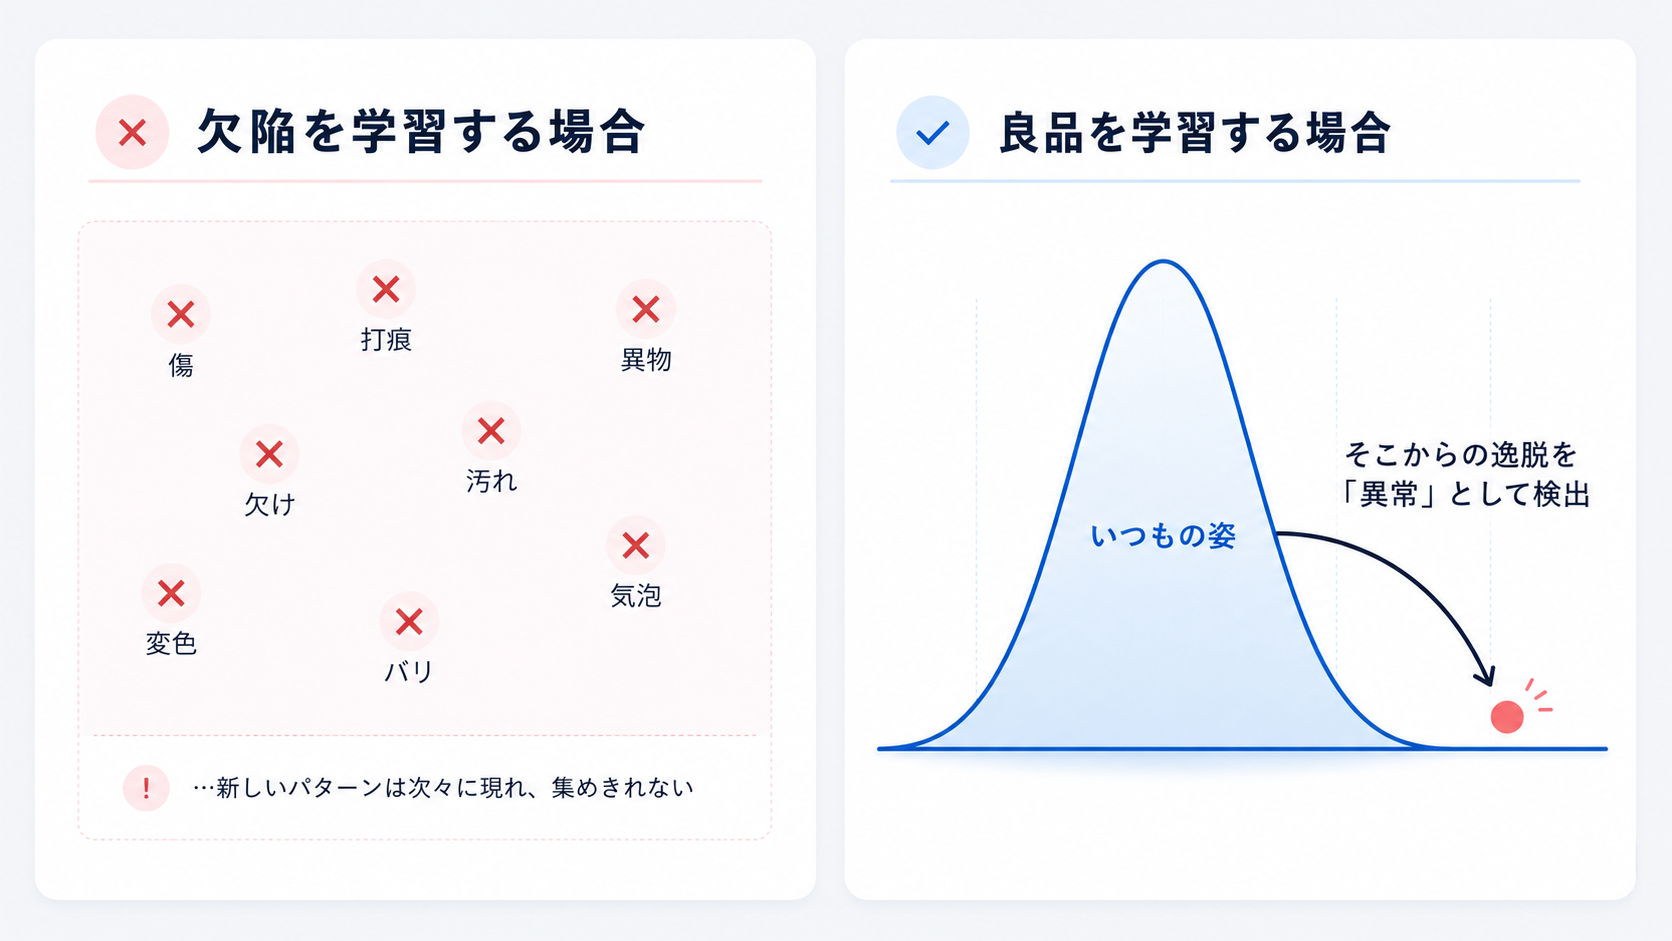
機械学習で欠陥を見つけようとするとき、素直に考えれば「欠陥を学習させる」ことになります。しかし欠陥の見た目は一定ではありません。傷、打痕、異物、欠けと種類が多いだけでなく、たとえば「傷」一つとっても、形も長さも深さも向きも毎回違います。パターンは事実上無数にあり、学習に足る数を網羅的に集めることは現実的ではありません。
そこで発想を逆にしたのが良品学習です。日々安定して手に入る良品だけを学習し、そこから逸脱したものを「異常」として検出します。 不良サンプルがほとんど無い工程でも立ち上げられます。この仕組みは「異常検知」と呼ばれる技術です。手法どうしの比較は「外観検査AIの種類と比較」で解説しているので、本記事はこの異常検知の中身に絞ります。
AIが学んでいるのは「いつもの姿」
良品学習型AIは、学習画像から「良品はいつもこういう姿をしている」という分布を作ります。検査時には、目の前のワーク(検査対象物)が分布の中心からどれだけ離れているか(逸脱度)を測り、大きく逸脱していれば異常と判定します。
ここでは説明のため、画像から取り出した特徴を「表面のムラ指標」という架空の1次元の数値に単純化します。日常の良品が平均40、ばらつき(標準偏差σ)4に分布しているとすると、たとえば「平均より3σ以上大きければ異常」と決めれば、しきい値は52になります。実際のAIは多次元の特徴量で同じことをしています。しきい値の決め方自体は手法や製品によってさまざまですが、学習した分布が土台になる点は変わりません。
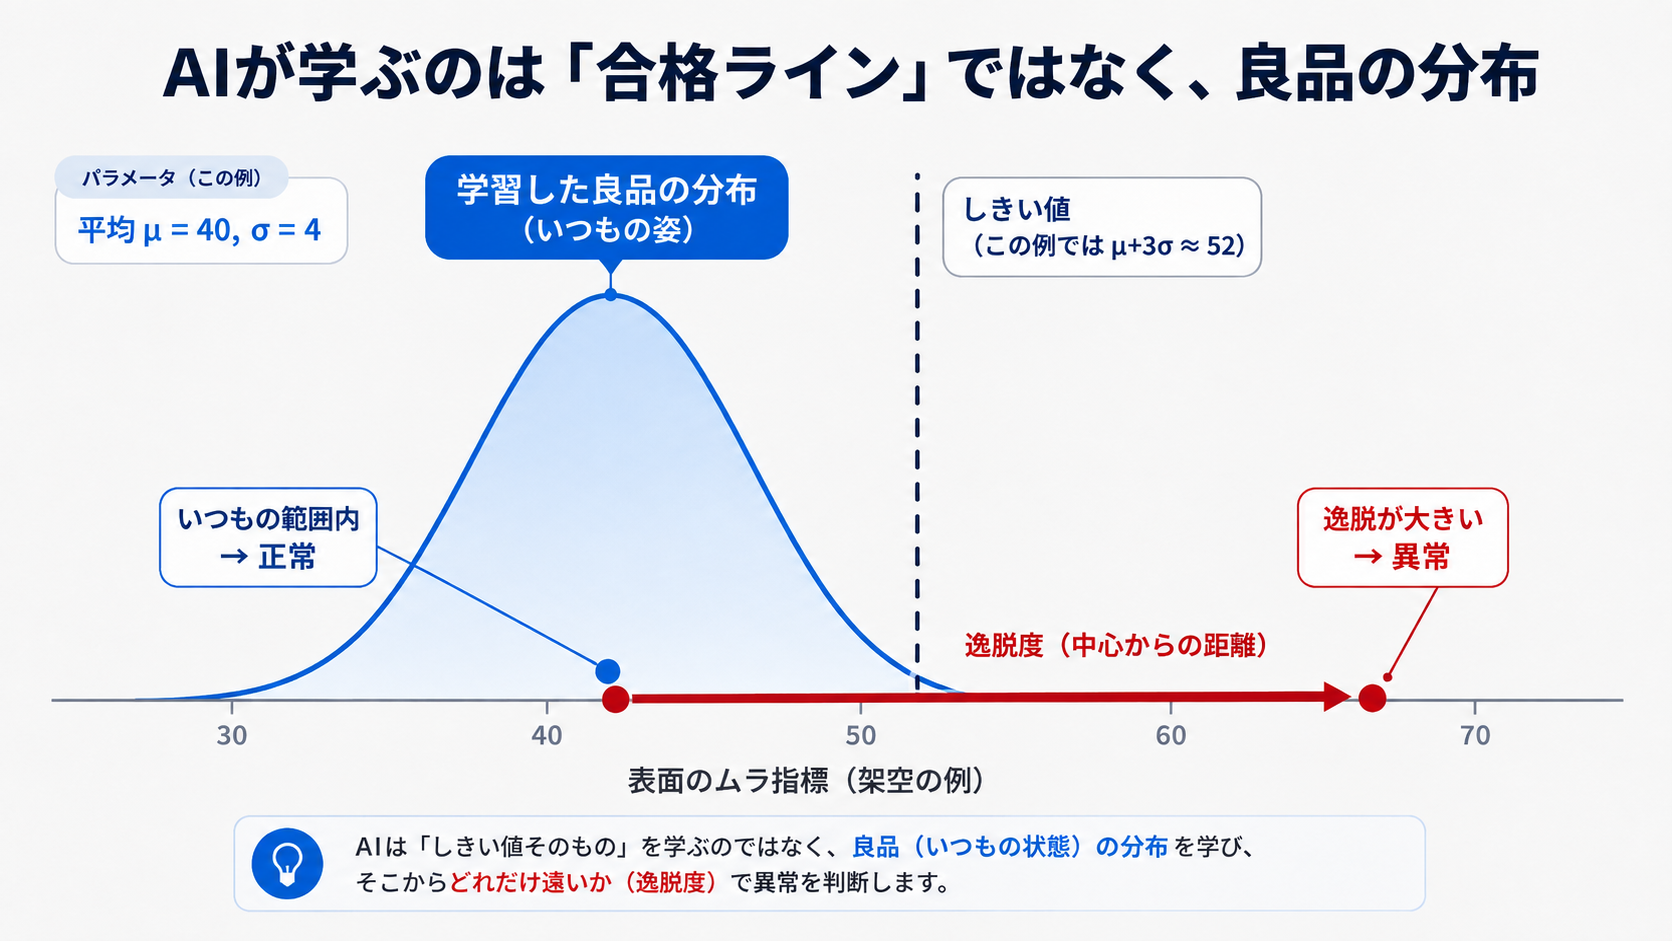
押さえておきたいのは、AIは「ここまでが合格」という合否の境界を学んでいないという点です。学んでいるのは良品の分布だけです。言い換えると、学習が作っているのは逸脱度を測る「ものさし」であり、しきい値はそのものさしのどの目盛りで切るかという後づけの話です。そしてAIは、見せられた良品だけから「いつも」を推定するため、見せ方しだいで、ものさしは狭すぎにも広すぎにも歪みます。ここからは、ものさしが現場でどう歪むか――避けられない「狭すぎ」と、やってはいけない「広げすぎ」――を順に見ていきます。
まず直面するのは「狭すぎ」による過検出
学習を始める時点で手元にあるのは、直近の1ロット分だけ、条件の揃った短期間の品だけ、ということがほとんどです。限られた良品で学習すると、AIが学ぶ「いつも」のばらつきは工程全体のばらつきより小さくなります。できあがるのは、正常なばらつきまで異常と読み取ってしまう、狭すぎるものさしです。しきい値は内側に寄り、日常の正常なばらつきまで異常と判定されます(この例では良品の約16%)。

これは失敗というより、避けて通れない出発点です。工程の全ばらつきを最初から網羅した良品セットは、まず手元にありません。しかも工程は生きています。材料ロットの切り替わりや設備の状態で「いつも」自体が少しずつ動き、順調だったAIが過検出を増やし始めることもあります。ですから良品学習型AIは、狭いものさしから出発し、実態に合わせて広げていく前提で運用します。広げ方は後述するとして、先に、このときやってはいけない広げ方を押さえておきます。なお、偏った学習データと過検出の関係は外観検査AIの過学習とはで詳しく解説しています。
やってはいけないのは、限度ぎりぎりの品で一気に広げること
過検出が続くと、「ここまではOKだとAIに教えたい」と、良品限度見本ぎりぎりの品を集めて一気に学習させたくなります。人に検査基準を教えるときと同じ、善意の発想です。
しかしAIはそれを境界とは受け取りません。「こういう品がいつも流れている」と受け取ります。 例えば下の例のように稀にしか出ない限度ぎりぎりの品が学習データの3割を占めると、分布は右へ広がり、しきい値は54から62近くまで外側へ動きます。すると、限度品よりわずかに悪い「軽微な不良」が「いつもの範囲」に入ってしまい、見逃されます。明確な不良は捕まるため、運用がしばらく進むまで気づきにくい失敗です。
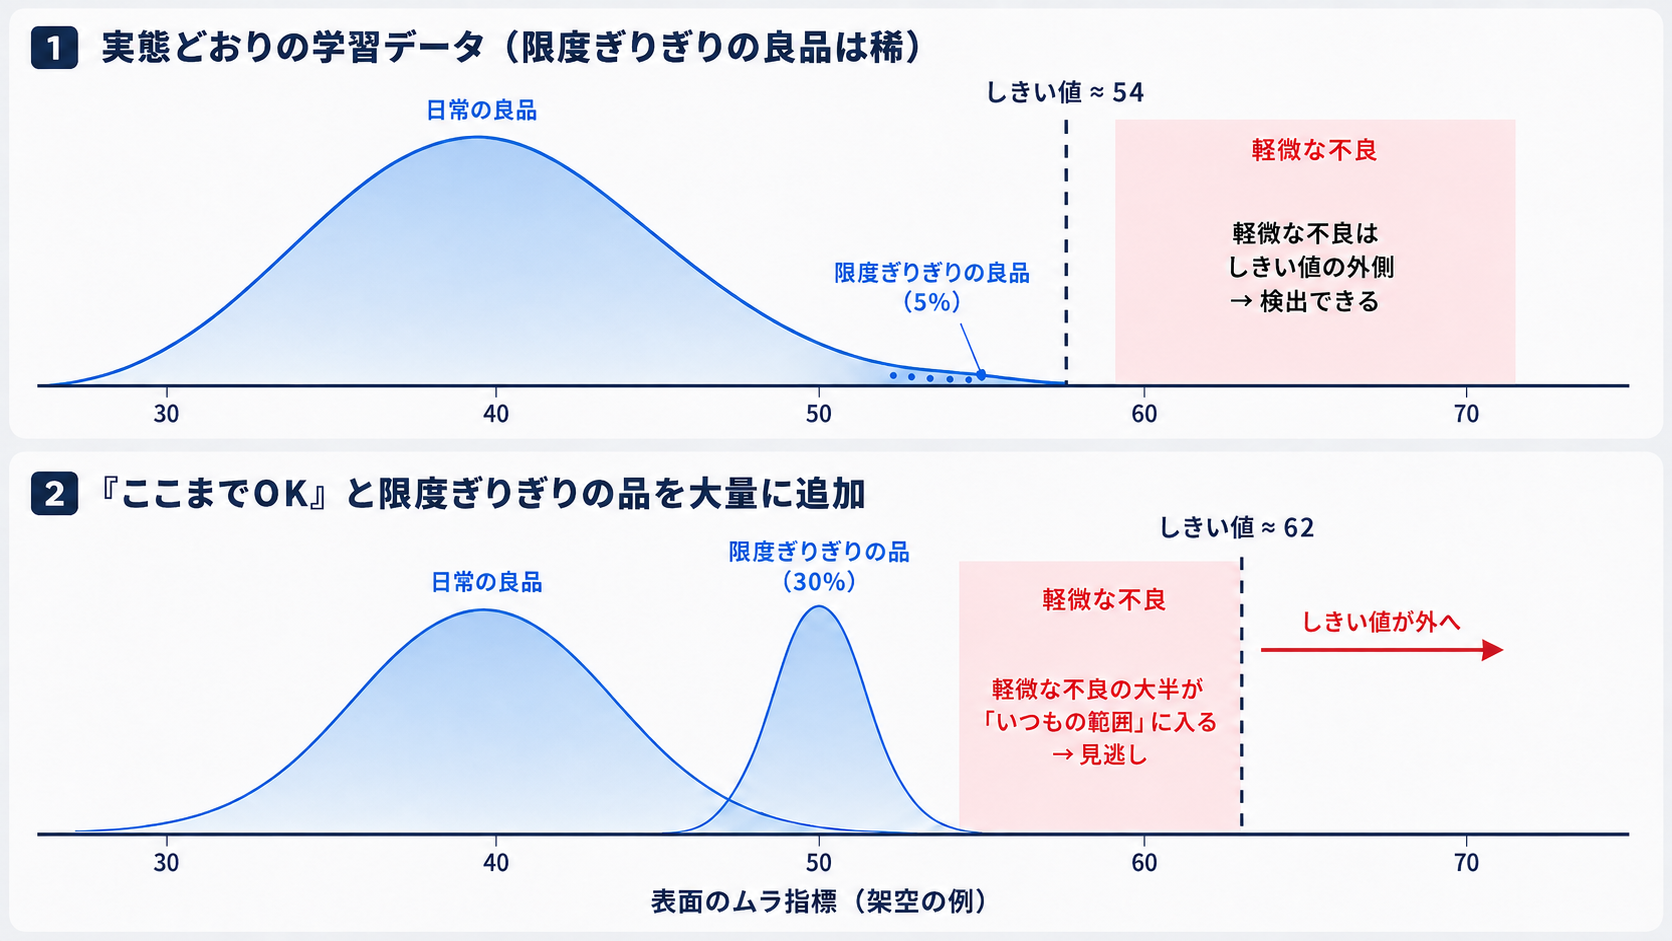
さらに厄介なことに、これはしきい値を調整し直せば済むとは限りません。実際のAIでは、限度ぎりぎりの品を大量に見せられると、そうした品と普通の良品を区別しないものさしができあがってしまい、分布そのものが軽微な不良側まで滲んでしまうため、しきい値をどこへ動かしても両者を測り分けられなくなることがあります。
品質管理に馴染みのある方なら、工程能力指数(Cpk)を求めるとき、わざわざ限度見本のデータを混ぜてばらつきを計算する人はいない、と考えると腑に落ちるのではないでしょうか。
運用の中で「いつもの姿」に近づけていく
目指す状態ははっきりしています。日常のラインを流れる良品が、生産の実態どおりの比率で学習されていることです。
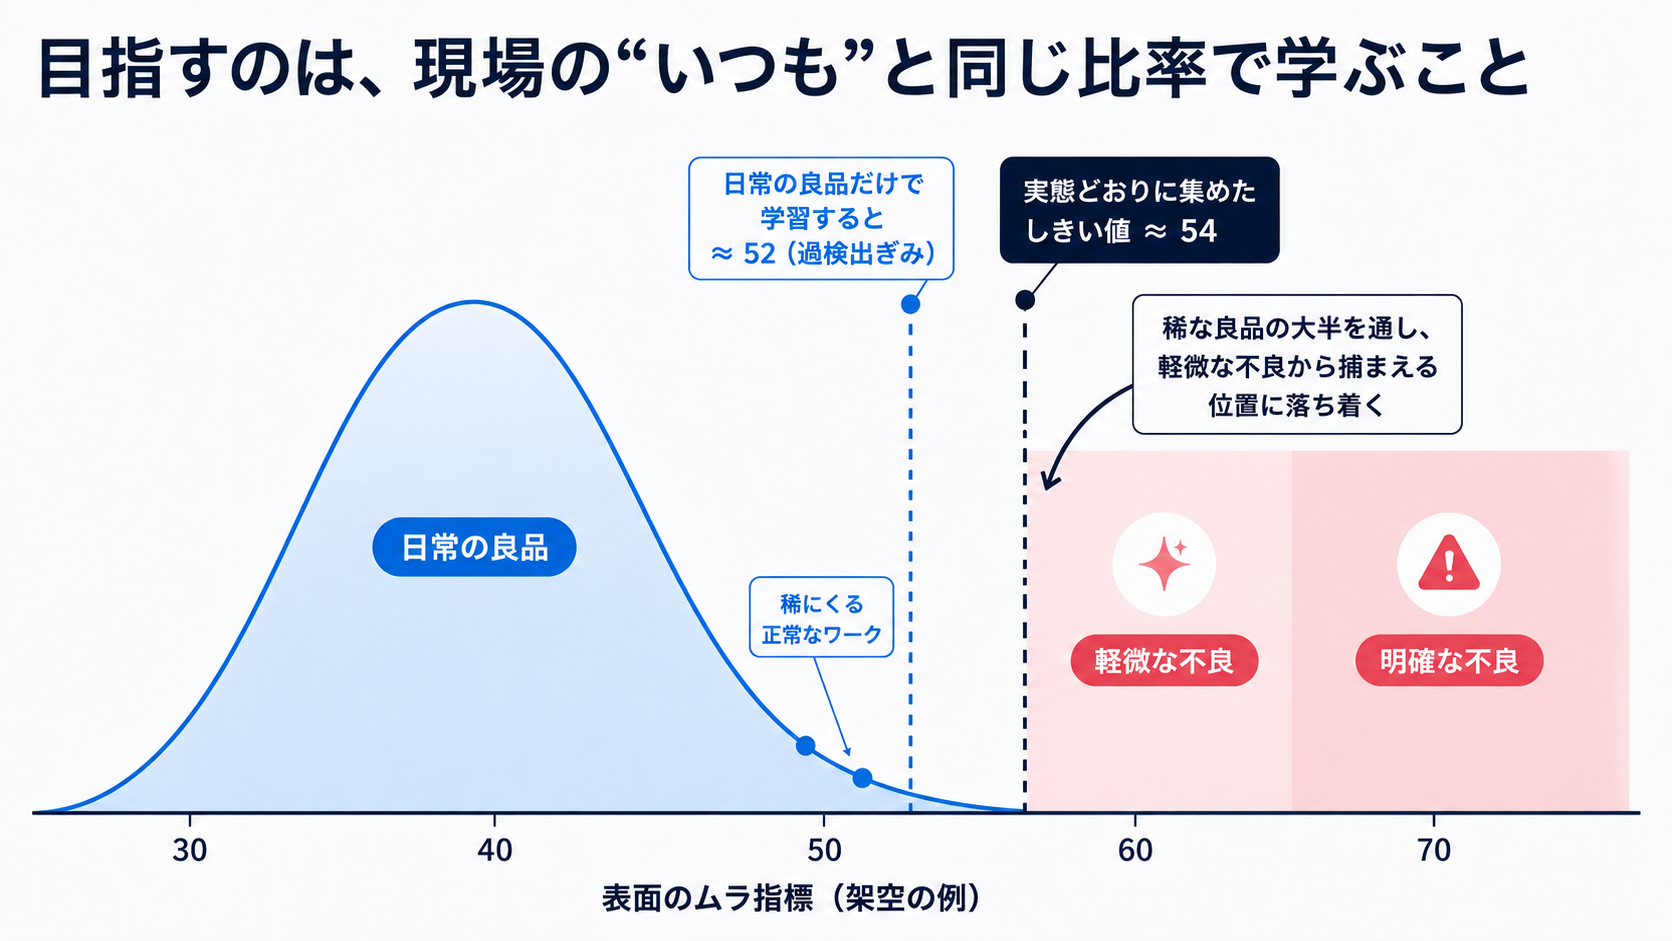
この状態へ一足飛びには行けないので、実践では運用しながら近づけます。軸になるのは、過検出されたワークのうち「どう見ても良品」のものを学習データに取り込み、再学習することです。この繰り返しで、ものさしが実態のばらつきを覚えていきます。工程の変化で「いつも」が動き、過検出が増えてきたときも対応は同じで、それはものさしを実態に合わせ直す合図です。取り込んだ良品画像が蓄積してきたら、どれを学習に使うかの選別を「正常蒸留」のような仕組みに任せる方法もあります。
気をつけたいのは、「教えたいから」と限度ぎりぎりの品を恣意的に混ぜないことです。前章の失敗を小分けに繰り返すことになります。限度見本はここでは学習には混ぜず、学習後の判定を確かめる材料として使う方が有効です。
よくある質問
外観検査における異常検知とは何ですか?
良品だけを学習して「いつもの姿」を把握し、そこから大きく外れたものを異常として検出する技術です。欠陥の見た目は種類も形も毎回異なり、学習に足る数を網羅的に集めるのが難しいため、日々安定して手に入る良品を学習する方法がとられます。不良サンプルがほとんどない工程でも立ち上げられるのが特徴です。
良品学習型AIは何を学習しているのですか?
良品の特徴がどのように分布しているか、つまり「良品はいつもこういう姿をしている」という分布を学習しています。「ここまでが合格」という合否の境界を学んでいるわけではありません。検査時には、ワークが分布の中心からどれだけ離れているか(逸脱度)を測って判定します。
しきい値はどのように決まるのですか?
学習した良品の分布をもとに、逸脱度のどこで線を引くかを決めます。本記事の例では「平均より3σ以上離れたら異常」としていますが、実際の決め方は手法や製品によってさまざまです。どの方法でも、学習した分布が土台になる点は変わりません。
良品限度見本は学習データに入れるべきですか?
学習データには入れず、学習後の判定を確かめる材料として使う方が有効です。限度ぎりぎりの品を多く学習させると、AIはそれを「いつも流れている品」と受け取り、分布が広がって軽微な不良を見逃す原因になります。
立ち上げ直後に過検出が多いのはなぜですか?
最初に手元にある良品は、直近のロットや短期間のものに限られることが多く、AIが学ぶばらつきが工程全体より小さくなるためです。過検出されたワークのうち「どう見ても良品」のものを学習データに取り込み、再学習を繰り返すことで、実態に近づけていきます。具体的な進め方は「外観検査AIの過検出を減らす方法」で紹介しています。
まとめ:AIに教えるのは「合格の範囲」ではなく「いつもの姿」
良品学習型AIの学習データ集めで迷ったら、次の3点に立ち返るのが有効です。
- 良品学習型AIが学ぶのは合否の境界ではなく、良品の「いつもの姿」(分布)である
- 立ち上げ期や工程が変化したあとの過検出は避けられない。過検出された「どう見ても良品」を学習に取り込みながら、ものさしを実態に合わせて広げていく
- 「ここまでOK」と限度ぎりぎりの品を教え込むのはNG。分布が広がりすぎて、軽微な不良の見逃しにつながる
「どこまでOKか」を一度に教え込むのではなく、工程の「いつも」を運用の中で少しずつ見せていくことが、良品学習型AIの性能を引き出す近道です。
アダコテックの良品学習AI「AdaInspector」は、良品画像だけで学習でき、GPUを使わずCPUで高速に判定する外観検査AIです。良品学習型AIによる外観検査の導入や学習データの設計など、外観検査に関するご相談はお問い合わせフォームから、製品の詳しい資料は資料ダウンロードからお気軽にどうぞ。各製品の概要は、この下の製品一覧からご覧いただけます。
PRODUCTS
アダコテックの外観検査AI・品質管理ソリューション
