
外観検査AIの学習画像は何枚必要か|良品20〜200枚の検証結果
 松本一樹
外観検査AIの導入相談で、特に多くいただく質問の一つが「良品画像は何枚用意すればよいか」です。ただ、この問いに「100枚あれば十分」といった一律の数字でお答えすることはできません。必要な学習枚数は、検出したい欠陥の大きさやコントラスト、良品のばらつき、求める検出レベル、そして許容できる良品の過検出率によって変わるためです。
そこで本記事では、良品学習型の外観検査AIを用いて、学習に使う良品画像を20枚・50枚・100枚・200枚と変えたときに、検査性能がどう変化するかを検証しました。その結果をもとに、学習枚数の考え方と、効率よく学習画像を揃える進め方を解説します。
検証結果:欠陥の難易度が高いほど、多くの良品画像が必要になる
本検証では、検出の難易度に応じて欠陥を低・中・高の3段階に分け、評価用のNG画像をすべて検出できるしきい値に設定したときの良品の過検出率を、学習枚数ごとに比較しました。
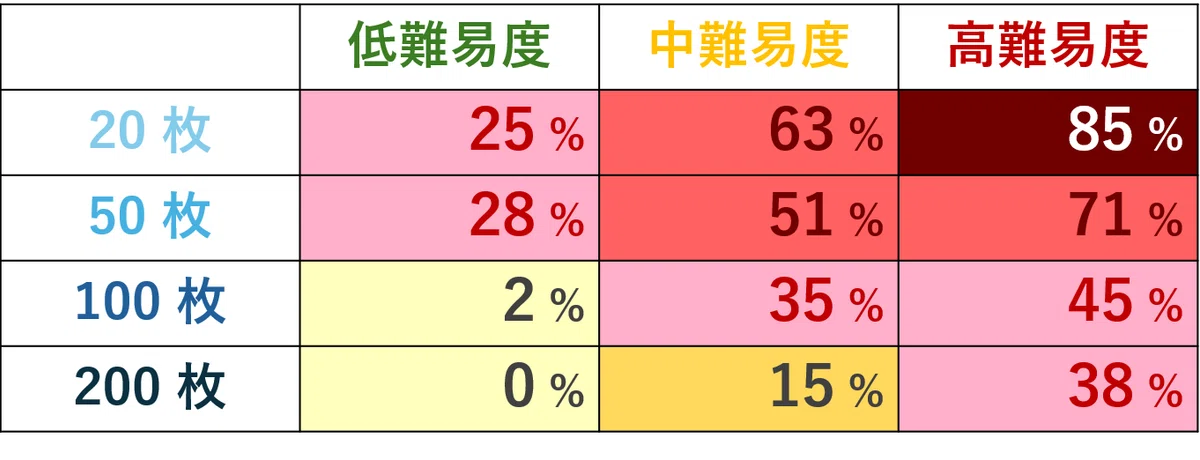
低難度の欠陥は、100枚の時点で良品の過検出がほぼなくなりました。中難度・高難度の欠陥でも、学習枚数を増やすほど良品の過検出率は下がりましたが、同じ枚数で比べると、難易度が高いほど過検出率は高くなっています。
つまり、最初に考えるべきは「何枚必要か」ではなく、「どの難易度の欠陥を、どの程度の過検出率で捉えたいか」です。必要な枚数は、この目標を決めて初めて見積もれるものです。
検証の方法|データの選定と欠陥の難易度区分
検証データの選定
検証には、外観検査AIの評価で一般的に使われている画像データセットを用いました。学習枚数による違いを観察しやすくするため、その中から次の特徴を持つ、検出の難易度が高いデータを意図的に選定しています。
- 良品の中に、欠陥と見分けにくい模様や色むらなど、見た目のばらつきが大きい
- サイズが小さく、コントラストの低い欠陥を含む
こうした模様や色むらは欠陥ではなく、良品としての特徴です。AIには、これらも「正常な見た目の一部」として学習させる必要があります。良品学習AIにとって条件の厳しい対象ですが、学習枚数による性能差がはっきり表れるため、比較の目的に適していると判断しました。
欠陥の3区分
欠陥は、サイズとコントラストをもとに3段階に分けました。
- 低難度:大きなキズや高コントラストの異物など、良品との違いが明確な欠陥
- 中難度:コントラストは高いもののサイズが小さい欠陥、またはサイズは大きいもののコントラストが低い欠陥
- 高難度:サイズもコントラストも小さく、一見しただけでは位置を判断しにくい欠陥。良品のばらつきと見分けにくい微細なものを含む
学習枚数ごとの異常スコア分布の変化
グラフの読み方
ここからは、学習枚数を増やすと異常スコアの分布がどう変わるかを、グラフで確認します。
- 横軸:AIが算出した異常スコア(値が大きいほど「いつもと違う」と判断)
- 縦軸:割合(%)
- 青:良品画像のうち、その異常スコア以上となった割合
- オレンジ:NG画像のうち、その異常スコア以下にとどまった割合
- 破線:評価用のNG画像をすべて検出できるしきい値
破線の位置で青が示す値が、そのときの良品の過検出率にあたります。青とオレンジが重なる範囲が狭いほど良品とNGを区別しやすく、重なりが広いほど、見逃しを防ごうとしたときに過検出が増えることになります。良品学習型AIが異常スコアをどのように算出しているかは「外観検査AIの異常検知とは」で解説しています。
低難度の欠陥
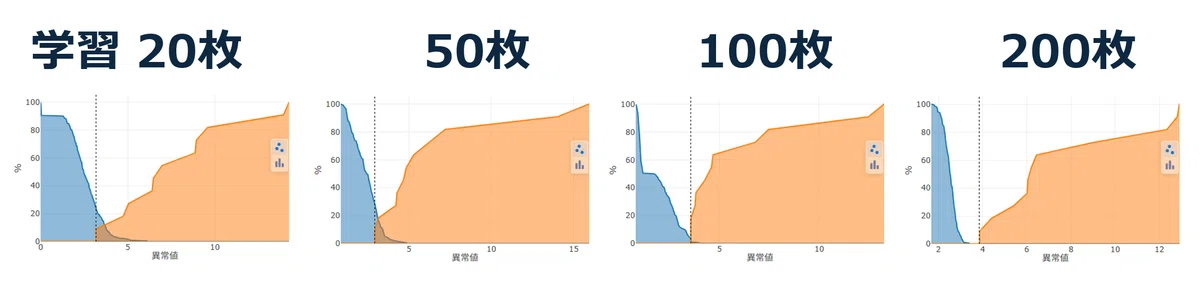
20枚・50枚の時点では青とオレンジの重なりが残り、破線の位置での良品の過検出率は2〜3割程度でした。100枚以降は重なりがほぼなくなり、安定して区別できる状態になりました。
中難度の欠陥
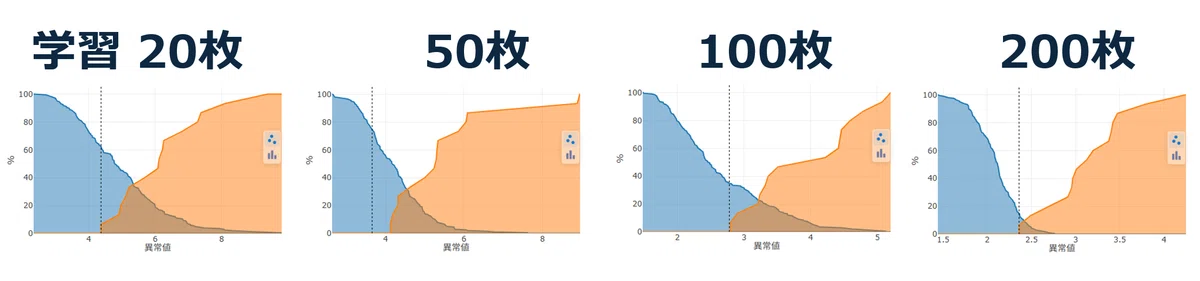
低難度に比べると、良品とNGの分布は大きく重なっています。ただし学習枚数を増やすにつれて分離が進み、200枚では重なりがかなり小さくなりました。
高難度の欠陥
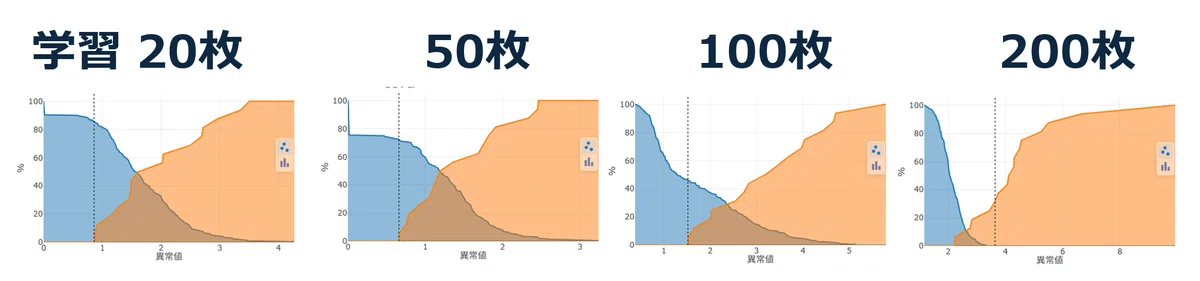
20枚・50枚では分布の重なりが大きく、良品とNGを十分に分離できていません。100枚、200枚と増やすにつれて性能は向上しましたが、200枚の時点でも一部に重なりが残りました。今回の検証は200枚までのため、さらに枚数を増やした場合にどこで性能の伸びが落ち着くかは、本検証の範囲外です。
検証から見えた2つの傾向
学習枚数だけを20・50・100・200枚と変えた4つのモデルを、同じ評価画像で比較しました。低難度の欠陥は100枚で十分に分離でき、中難度の欠陥は200枚で大きく改善しました。高難度の欠陥は、200枚の時点でもさらに改善の余地が残っています。
興味深い点として、低難度の欠陥では、20枚から50枚に増やした際に一時的に性能が下がりました。学習枚数が少ないうちは、どの画像を選んだかという組み合わせの影響を受けやすいためと考えられます。
以上から、次の2点が見えてきます。
- 欠陥の難易度が高いほど、多くの良品画像が必要になる傾向がある
- 少数の学習では結果が安定しにくく、枚数だけでなく画像の中身が重要になる
必要枚数を一律に決められない理由
良品学習では、正常品に含まれる見た目のばらつきをAIに学習させます。欠陥ではなくても、製品には次のような個体差があります。
- 色や明るさの違い
- 表面模様の違い
- 位置や角度のずれ
- 加工条件によるばらつき
- 撮像時のわずかな揺らぎ
学習画像が少ないと、AIは正常な範囲を十分に把握できません。その結果、欠陥は検出できても、良品の多くをNGと判定するモデルになる可能性があります。
ただし、枚数を増やせば増やすほどよいというわけでもありません。似た画像を大量に追加しても、AIが学べる正常範囲はほとんど広がりません。重要なのは枚数そのものではなく、実際に発生する良品のばらつきが学習画像に含まれているかどうかです。学習画像の偏りと過検出の関係は「外観検査AIの過学習とは」で詳しく解説しています。
評価では「検出率」と「過検出率」をセットで見る
AI外観検査の評価では、「NGを検出できたか」という結果に注目が集まりやすい傾向があります。
しかし、すべての製品をNGと判定するモデルでも、NGの検出率は100%になります。もちろん、そのようなモデルは現場では運用できません。
実際に運用できるかどうかを判断するには、次の2点をセットで確認します。
- 見逃してはいけないNGを検出できるか
- その状態で、良品の過検出率を許容範囲に収められるか
必要な学習枚数を見極める際も、見逃したくないNGを検出できるしきい値に設定したうえで、良品の過検出率を確認することが重要です。本記事の検証も、この考え方に沿って評価しています。
少数の画像から始めて、追加学習で広げる
とはいえ、検査対象ごとに最初から数百枚の良品画像を集める必要はありません。まずは少数の画像でモデルを作り、結果を確認します。過検出された良品に、まだ学習していない正常なばらつきが含まれていれば、その画像を追加して再学習します。
- 少数の良品画像で学習する
- NGの検出率と良品の過検出率を確認する
- 過検出された良品の傾向を分析する
- まだ学習していない正常なばらつきを追加する
- 再学習し、性能を比較する
大切なのは、やみくもに枚数を増やさないことです。どの良品がNGと判定されたかを確認し、AIがまだ把握していない正常範囲を補っていくことで、効率よく精度を高められます。過検出の原因の切り分けや追加学習の具体的な進め方は「外観検査AIの過検出を減らす方法」で紹介しています。
よくある質問
外観検査AIの学習には、良品画像が何枚必要ですか?
一律の枚数は決まっていません。検出したい欠陥の大きさやコントラスト、良品のばらつき、求める検出レベル、許容できる過検出率によって変わります。本記事の検証では、欠陥の難易度が高いほど多くの良品画像が必要になる傾向が見られました。
学習枚数を増やせば、精度は必ず上がりますか?
必ずしもそうとは限りません。似た画像を追加しても、AIが学べる正常範囲はほとんど広がらないためです。実際に発生する良品のばらつきを学習画像に含めることが重要です。
最初から大量の良品画像を集める必要はありますか?
必要ありません。少数の画像で学習と評価を行い、過検出された良品のうち、まだ学習していない正常なばらつきを含む画像を追加して再学習する進め方が効率的です。
まとめ:学習枚数は「欠陥の難易度」と「許容できる過検出率」から考える
学習枚数を20・50・100・200枚と変えた検証から、学習画像の準備では次の3点が要点になります。
- 欠陥の難易度が高いほど、良品の過検出を抑えるために多くの良品画像が必要になる
- 枚数そのものより、実際に発生する良品のばらつきが学習画像に含まれていることが重要
- 最初から枚数を決め打ちせず、少数で学習・評価し、不足しているばらつきを追加していく
「何枚必要か」の答えは、検出したい欠陥と許容できる過検出率を定めることで見えてきます。少数から始めて結果を確認しながら広げていくことが、外観検査AIの学習画像を効率よく揃える現実的な進め方です。
学習画像の準備や評価の進め方など、外観検査に関するご相談はお問い合わせフォームから、製品の詳しい資料は資料ダウンロードからお気軽にどうぞ。各製品の概要は、この下の製品一覧からご覧いただけます。
PRODUCTS
アダコテックの外観検査AI・品質管理ソリューション
